DocWeave是一款专注于隐私与效率的本地离线OCR文档扫描与识别工具。通过在设备本地运行AI识别模型,它能够将PDF文件、图片以及纸质文档转化为可编辑的结构化内容,无需联网即可完成所有处理流程,确保您的文档资料始终保存在设备内部。
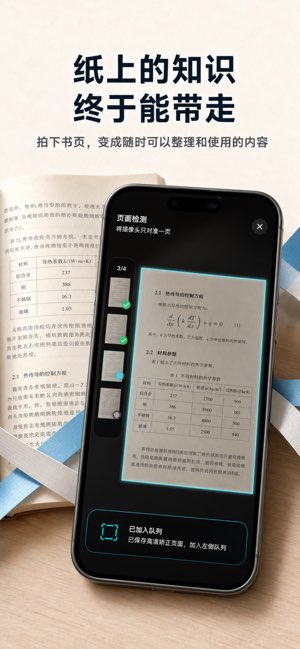
1. 纸质文档处理:在iPhone和iPad上支持自动检测页面,通过连续拍摄功能快速采集书页、讲义、票据等纸质资料,并自动加入识别处理队列。
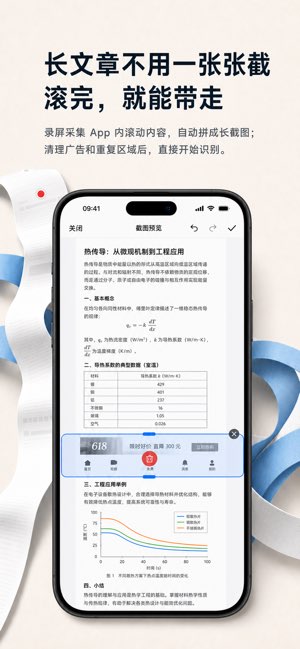
2. 滚动内容采集:支持录制网页或长文章的滚动过程,自动拼接成长截图,并允许在识别前删除广告、重复区域或无关内容,实现精准采集。
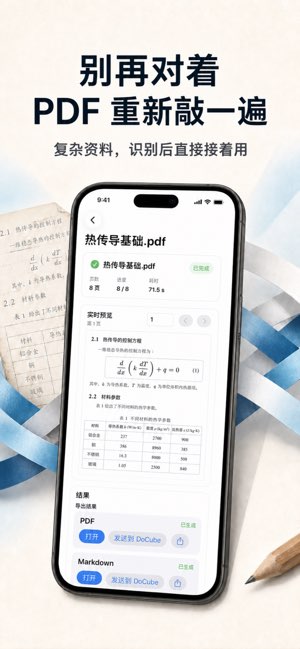
1. 复杂版面理解:不仅能提取纯文本,还能智能识别段落结构、表格数据、LaTeX公式、代码块以及算法块,满足专业文档的还原需求。
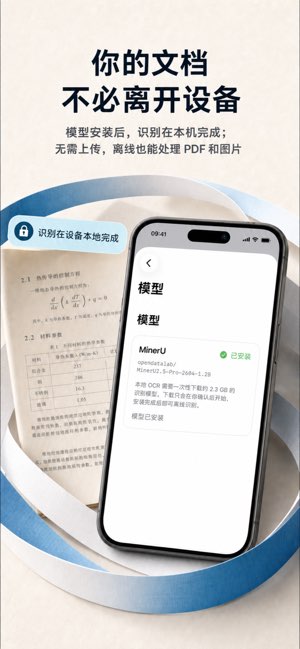
2. 离线处理模式:首次使用完成模型下载后,后续识别过程无需联网,所有图像处理与推理均在本地完成,有效保障文档隐私与安全性。
1. 多格式导出:支持一次性生成重建PDF、Markdown、EPUB以及MinerU结果包,方便用户进行后续的阅读、编辑、归档或进一步处理。
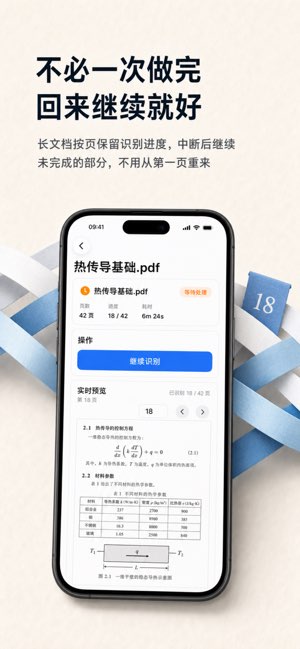
2. 中断续传机制:模型下载、页面采集或大文档识别过程中,即使意外中断,也可从已有进度继续,无需重新开始处理流程。
1. 实时预览:应用支持边识别边预览功能,每完成一页即可查看结构化结果,让用户随时掌握当前处理状态和排版效果。
2. 硬件要求:由于采用本地AI模型,建议在配备至少8GB内存的设备上使用,以获得流畅的扫描与识别体验。
DocWeave是一款非常适合需要高隐私、高精度文档处理需求的用户。其核心亮点在于完全离线的本地AI模型,既保证了文档安全,又提供了包括公式、代码在内的复杂版面识别能力。对于经常需要处理学术资料、讲义或需要将纸质内容数字化的用户来说,是一款高效且实用的工具。
1.2.0 带来全新的移动端资料采集体验: • iPho
e 和 iPad 新增纸质文档扫描,支持自动检测页面、连续拍摄并加入识别队列。 • 新增滚动内容采集:录制网页或长文章的滚动过程,自动拼接成长截图;识别前还可删除广告、重复区域和无关内容。 • 识别进度按页保存,中途退出或切换应用后,可以从已有进度继续,无需重新开始。 • 优化识别进度显示和实时预览,更容易了解当前处理状态。 • 新增多语言帮助中心,提供模型安装、文件导入、拍摄扫描、滚动采集、导出和常见问题说明。 • 改进页面检测、重复页面判断、长截图拼接速度及整体稳定性。 文档识别和处理仍然全部在设备本地完成。

飞鱼浏览器
 苹果应用 / 54.8 MB / 2026-07-28
下载

私人浏览器-dip
苹果应用 / 138 MB / 2026-07-14
下载

易览浏览器
 苹果应用 / 27.7 MB / 2026-07-28
下载

菜谱大全
苹果应用 / 22.9 MB / 2026-08-07
下载

文件管理免费版
苹果应用 / 15.5 MB / 2013-12-23
下载

超级浏览器
苹果应用 / 33.5 MB / 2026-07-28
下载

Apple 健康
 苹果应用 / / 2026-08-07
下载

点外卖吧
 苹果应用 / 18.1 MB / 2026-08-07
下载


 手机文档处理软件
 文档扫描小助手
 文档扫描
 文档扫描识字仪
 PDF转换器
 Doc Scan Pro
 PDF & Document Scanner
 Doc : Image to Excel Converter